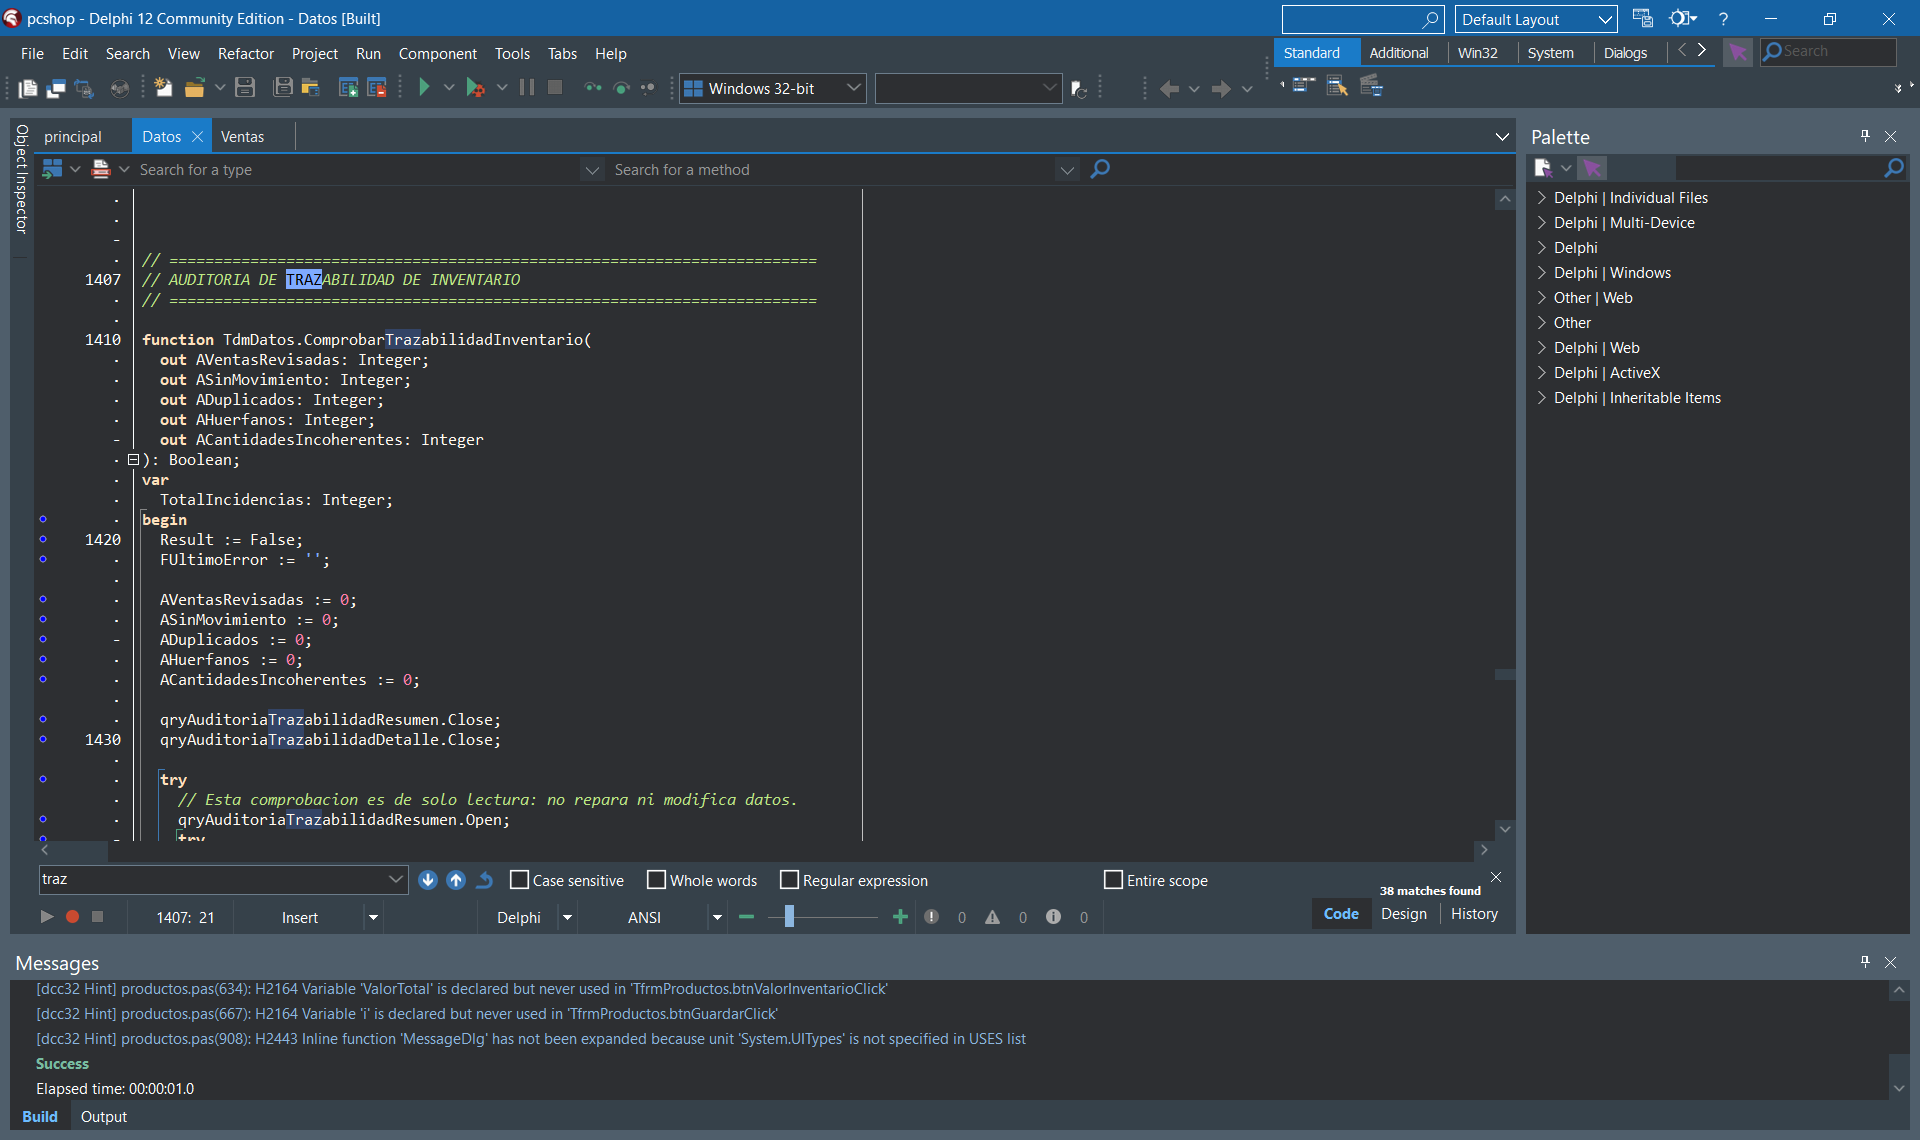
¿Sabría nuestra BBDD explicar cómo ha llegado hasta un número de productos, detectar incoherencias y proteger las nuevas reglas sin alterar el histórico?
…Cuando empezamos una aplicación de gestión es relativamente sencillo pensar en términos de CRUD: crear productos, modificarlos, eliminarlos y consultar la información.
Pero una aplicación empieza a resultar realmente interesante cuando deja de ser un proyecto vacío y comienza a tener datos que debemos conservar.
Ahí aparecen problemas diferentes.
Ya no basta con preguntarnos: ¿cómo añado esta función?
También tenemos que preguntarnos: ¿cómo añado esta función sin romper los datos que ya existen?
Eso es precisamente lo que ha ocurrido durante la evolución de PC Shop, una aplicación de escritorio desarrollada con Delphi, VCL, FireDAC y SQLite.
El proyecto ya disponía de productos, clientes, ventas y control de stock. El siguiente objetivo era que el inventario no se limitara a mostrar el número actual de unidades, sino que pudiera explicar cómo había llegado hasta ese número, detectar incoherencias y proteger las nuevas reglas sin alterar el histórico.
El resultado ha sido una evolución desde un simple valor de stock hasta un pequeño sistema de trazabilidad:
PRODUCTOS.Stock
        ↓
MOVIMIENTOS_STOCK
        ↓
ENTRADA / SALIDA / AJUSTE
        ↓
transacción stock + movimiento
        ↓
VENTA → SALIDA automática
        ↓
MOVIMIENTOS_STOCK.IdVenta
        ↓
auditoría
        ↓
datos históricos vs. datos modernos
        ↓
migración del esquema
        ↓
protección adicional en SQLite
1. Saber el stock actual no es suficiente
Supongamos que tenemos:
PRODUCTOS.Stock = 7Sabemos que quedan siete unidades.
Pero no sabemos por qué quedan siete.
- Podrían haberse vendido varias unidades.
- Podría haber entrado nueva mercancía.
- Podría haberse corregido un error de inventario.
- Podría haberse realizado un ajuste manual.
El valor final no cuenta la historia. Por eso PC Shop necesitaba una segunda entidad: MOVIMIENTOS_STOCK.
La idea es sencilla: PRODUCTOS.Stock continúa indicando el estado actual,
mientras que MOVIMIENTOS_STOCK explica cómo ha cambiado ese estado con el tiempo.
2. Crear MOVIMIENTOS_STOCK
La nueva tabla almacena información propia del movimiento:
IdMovimiento
Fecha
CodigoProducto
Tipo
Cantidad
Motivo
IdVenta
Los tipos iniciales son:
ENTRADA
SALIDA
AJUSTE
Aquí aparece una decisión importante de diseño.
No tiene sentido almacenar también en cada movimiento:
NombreProducto
NombreCliente
Precio
ImporteVenta
Esa información ya existe en otras entidades. Duplicarla facilitaría que aparecieran contradicciones.
Si cambia el nombre de un producto, por ejemplo, podríamos acabar teniendo un nombre en
PRODUCTOS y otro diferente almacenado dentro de movimientos antiguos.
Por eso es preferible guardar relaciones e información propia del movimiento y recuperar los demás datos mediante consultas cuando sean necesarios.
3. La cantidad representa una variación
Otro aspecto importante es decidir qué significa Cantidad.
En PC Shop no representa el stock final. Representa el cambio aplicado al inventario:
ENTRADA +5
SALIDA  -2
AJUSTE  +3
AJUSTE  -1
Por tanto, la regla general es:
StockNuevo = StockActual + CantidadEsta decisión simplifica considerablemente el sistema. No necesitamos una lógica diferente para aumentar y disminuir stock: todos los movimientos pueden interpretarse como variaciones positivas o negativas.
4. El modelo Delphi: TMovimientoStock
En Delphi, esta nueva entidad se representa mediante TMovimientoStock.
Para evitar trabajar internamente con cadenas de texto se utiliza un enumerado:
type
  TTipoMovimientoStock = (
    tmsEntrada,
    tmsSalida,
    tmsAjuste
  );
En el código Delphi podemos trabajar con:
tmsEntrada
tmsSalida
tmsAjuste
mientras que SQLite mantiene valores fácilmente comprensibles:
ENTRADA
SALIDA
AJUSTE
Para unir ambos mundos basta con disponer de funciones de conversión entre el enumerado Delphi y el texto almacenado en SQLite.
Es una solución sencilla, pero mejora la claridad del código y evita depender constantemente de cadenas escritas manualmente.
5. Proteger reglas también desde SQLite
La interfaz no debería ser la única responsable de impedir datos incorrectos.
Por ejemplo:
ENTRADA → Cantidad > 0
SALIDA  → Cantidad < 0
AJUSTE  → Cantidad <> 0
Estas reglas pueden reforzarse mediante restricciones CHECK en SQLite.
La idea es importante:
La calidad del dato no debería depender únicamente de que el formulario Delphi funcione correctamente.
La aplicación puede tener un error, puede modificarse en el futuro o incluso puede accederse a la base de datos desde otra herramienta.
Cuantas más reglas esenciales podamos expresar también en la propia base de datos, mayor será la protección.
6. Stock y movimiento deben formar una única operación
Un problema evidente sería modificar correctamente el stock pero fallar al registrar el movimiento.
Stock modificado       ✔
Movimiento registrado  ✘
También podría ocurrir lo contrario.
Por eso ambas operaciones deben considerarse una única unidad lógica:
BEGIN TRANSACTION
        ↓
UPDATE PRODUCTOS.Stock
        ↓
INSERT MOVIMIENTOS_STOCK
        ↓
COMMIT
Si cualquier parte falla:
ROLLBACKAsí conseguimos una propiedad fundamental:
O se realizan las dos operaciones o no se realiza ninguna.
Esto transforma algo aparentemente sencillo —modificar un número— en una operación mucho más robusta.
7. Integrar las ventas con la trazabilidad
Una vez creado el sistema de movimientos apareció el siguiente paso lógico.
Si una venta reduce el stock, debería dejar automáticamente una pista.
Por ejemplo, una venta de tres unidades debe generar:
Tipo     = SALIDA
Cantidad = -3
Motivo   = Venta
Pero aquí había que evitar otro error de diseño: no crear una segunda transacción distinta.
La venta ya era una operación transaccional. Por tanto, la nueva trazabilidad debía integrarse dentro de ella:
BEGIN TRANSACTION
        ↓
INSERT VENTA
        ↓
obtener IdVenta
        ↓
UPDATE PRODUCTOS.Stock
        ↓
INSERT MOVIMIENTOS_STOCK
        ↓
COMMIT
Si cualquiera de esos pasos falla:
ROLLBACKDe esta forma una venta no puede quedar registrada sin actualizar el inventario, y tampoco puede modificarse el stock sin dejar asociado su movimiento correspondiente.
8. Recuperar el identificador con last_insert_rowid()
Para relacionar el movimiento con la venta necesitamos conocer el identificador generado por SQLite.
Después de insertar en VENTAS podemos utilizar:
SELECT last_insert_rowid();
Hay una condición importante: debe ejecutarse sobre la misma conexión FireDAC
y conviene recuperar el identificador inmediatamente después del INSERT.
Por ejemplo:
VENTAS.Id = 37produce:
MOVIMIENTOS_STOCK.IdVenta = 37A partir de ese momento podemos navegar conceptualmente desde un movimiento hasta la venta que lo originó.
9. Por qué IdVenta debe admitir NULL
No todos los movimientos proceden de una venta.
Una entrada de mercancía o un ajuste manual no tiene ninguna venta relacionada.
Por eso MOVIMIENTOS_STOCK.IdVenta debe permitir NULL.
Movimiento manual
IdVenta = NULL

Movimiento generado por una venta
IdVenta = identificador real
No conviene almacenar IdVenta = 0 en SQLite para representar “sin venta”.
NULL expresa precisamente la ausencia de relación.
Internamente Delphi sí puede utilizar el valor 0 como representación en memoria si resulta conveniente, pero la base de datos mantiene la semántica correcta.
10. Registrar trazabilidad no basta: también hay que auditarla
Una vez que empezamos a relacionar ventas y movimientos aparece una pregunta muy útil:
¿Podemos comprobar automáticamente que todo sigue siendo coherente?
Para ello se incorporó una auditoría capaz de detectar cuatro situaciones.
A) Venta sin movimiento
Una venta moderna debería tener su salida de inventario correspondiente.
B) Movimiento duplicado
Una misma venta no debería generar accidentalmente dos movimientos automáticos.
C) Movimiento huérfano
Existe un movimiento con IdVenta, pero la venta correspondiente no existe.
D) Cantidad incoherente
Si tenemos:
VENTAS.Cantidad = 3el movimiento correspondiente debería indicar:
MOVIMIENTOS_STOCK.Cantidad = -3Una diferencia entre ambos valores indica una inconsistencia.
11. Reutilizar el sistema de logging existente
Otro principio importante durante el desarrollo ha sido evitar duplicar infraestructura.
PC Shop ya disponía de logging, así que la auditoría utiliza el mismo mecanismo y registra las incidencias en:
logs\pcshop.logPor ejemplo:
AUDITORIA INVENTARIO | SIN_MOVIMIENTO | Venta Id=...
AUDITORIA INVENTARIO | DUPLICADO | Venta Id=...
AUDITORIA INVENTARIO | HUERFANO | Movimiento Id=...
AUDITORIA INVENTARIO | CANTIDAD_INCOHERENTE | ...
No necesitamos un segundo sistema de logs solo porque estamos añadiendo una nueva funcionalidad.
12. La primera auditoría encontró ocho “errores”
El primer resultado fue:
Ventas revisadas: 9
Sin movimiento: 8
Duplicados: 0
Huérfanos: 0
Cantidades incoherentes: 0
A primera vista parecía que el sistema tenía ocho errores graves.
Pero al revisar los datos apareció una conclusión mucho más interesante.
Las ocho ventas sin movimiento habían sido creadas antes de que existiera MOVIMIENTOS_STOCK.
No eran nuevas ventas defectuosas. Eran datos perfectamente válidos bajo una versión anterior de la aplicación.
Este fue uno de los aprendizajes más interesantes de toda esta evolución:
Un dato histórico sin una característica nueva no es necesariamente un dato incorrecto.
El software había evolucionado, pero el histórico pertenecía a una versión anterior del modelo.
13. Distinguir datos históricos con VENTAS.Trazable
Para representar explícitamente esa diferencia se decidió incorporar:
Trazable INTEGER NOT NULL DEFAULT 0La interpretación queda así:
Trazable = 0
→ venta histórica
→ creada antes de existir la trazabilidad moderna

Trazable = 1
→ venta moderna
→ debe cumplir las reglas actuales
Las nuevas ventas se insertan expresamente con:
Trazable = 1mientras que las ventas existentes reciben el valor 0.
De esta forma no necesitamos inventar movimientos que nunca existieron ni modificar artificialmente el histórico.
14. El problema de evolucionar una tabla que ya contiene datos
Aquí aparece otro concepto muy importante.
Podemos tener originalmente:
CREATE TABLE IF NOT EXISTS VENTAS (...)
pero cambiar ese CREATE TABLE no modifica una tabla que ya existe.
IF NOT EXISTS significa precisamente que SQLite debe crearla únicamente cuando todavía no existe.
Por tanto, una instalación anterior no obtendrá automáticamente las nuevas columnas.
Para eso necesitamos una migración de esquema.
15. Migrar sin borrar la tabla VENTAS
PC Shop comprueba primero la estructura real mediante:
PRAGMA table_info(VENTAS);Después determina si la columna ya existe.
Si falta, se ejecuta:
ALTER TABLE VENTAS
ADD COLUMN Trazable INTEGER NOT NULL DEFAULT 0;
El DEFAULT 0 tiene una ventaja importante.
Las ventas anteriores reciben automáticamente:
Trazable = 0sin tener que eliminarlas ni reconstruir la tabla.
La aplicación puede evolucionar conservando sus datos.
16. La propia función de migración también tuvo que evolucionar
PC Shop ya utilizaba una migración anterior para incorporar IdCliente.
La lógica original buscaba esa columna y, cuando la encontraba, abandonaba el recorrido mediante Break.
Eso era suficiente cuando solamente había que comprobar una cosa.
Pero ahora necesitábamos conocer dos estados:
TieneIdCliente
TieneTrazable
Por tanto, ya no se podía abandonar el bucle al encontrar la primera columna.
Había que recorrer toda la estructura devuelta por:
PRAGMA table_info(VENTAS)y comprobar ambas.
Es un detalle pequeño, pero ilustra muy bien cómo funciona el mantenimiento:
Incluso el código creado previamente para permitir futuras migraciones puede necesitar evolucionar cuando aumenta el número de migraciones.
17. La auditoría después de distinguir el histórico
Una vez incorporado Trazable, la auditoría ya puede interpretar correctamente la base.
Las reglas pasan a ser:
Trazable = 0
→ dato histórico
→ no se exige movimiento automático

Trazable = 1
→ venta moderna
→ debe cumplir trazabilidad completa
Los movimientos huérfanos siguen siendo siempre una anomalía.
El resultado después del cambio fue:
Ventas revisadas: 1
Sin movimiento: 0
Duplicados: 0
Huérfanos: 0
Cantidades incoherentes: 0

TRAZABILIDAD CORRECTA
Ahora la auditoría ya no confunde ausencia histórica de una funcionalidad con corrupción de datos.
18. Evitar duplicados con un índice UNIQUE parcial
Después de comprobar que los datos modernos eran coherentes podíamos añadir otra capa de protección.
La regla era:
Una venta solamente puede tener un movimiento automático asociado.
SQLite puede reforzarla mediante:
CREATE UNIQUE INDEX IF NOT EXISTS UX_MOVIMIENTOS_STOCK_IdVenta
ON MOVIMIENTOS_STOCK(IdVenta)
WHERE IdVenta IS NOT NULL;
Esto produce un comportamiento apropiado para nuestro modelo.
Movimientos manuales:
IdVenta = NULLpueden existir tantos como sean necesarios.
Movimientos procedentes de ventas:
IdVenta = 37solo pueden existir una vez para esa venta.
19. ¿Por qué utilizar un índice parcial?
La parte:
WHERE IdVenta IS NOT NULLhace que el índice represente directamente la regla que queremos expresar.
Los movimientos manuales ni siquiera forman parte del índice.
Además, el propio índice puede ayudar en las búsquedas por IdVenta,
por lo que no necesitamos crear otro índice normal redundante sobre esa misma columna.
Es un buen ejemplo de cómo una decisión de integridad también puede contribuir al acceso eficiente a los datos.
20. Un UNIQUE tampoco lo resuelve todo
El índice impide algo muy concreto:
una venta → dos movimientos asociadosPero no puede comprobar por sí mismo:
- que todas las ventas tengan movimiento;
- que
Tipo = SALIDA; - que
Motivo = Venta; - que
Cantidad = -VENTAS.Cantidad; - que toda la relación sea semánticamente correcta.
Por eso no existe una única protección suficiente.
La solución completa combina:
Lógica Delphi
        +
Transacciones
        +
Auditoría
        +
Restricciones SQLite
        ↓
Mayor integridad y mantenibilidad
Es una pequeña forma de defensa en profundidad aplicada a la consistencia de los datos.
21. Los problemas que no aparecen en el diagrama ideal
Durante este desarrollo también aparecieron situaciones mucho más mundanas y, precisamente por eso, útiles para aprender.
Delphi mantenía archivos anteriores abiertos
En determinadas pruebas Delphi seguía teniendo abierto un .pas o .dfm anterior
después de que esos archivos hubieran sido sustituidos externamente.
En esos casos era necesario cerrar y volver a abrir el proyecto para asegurarse de que se estaba probando realmente la versión correcta.
TFDQuery activo desde el Designer
También apareció otro caso con FireDAC.
Activar un TFDQuery desde el Designer mediante:
Active = True
podía producir errores porque la ruta real de SQLite se configura durante DataModuleCreate.
Es decir, la conexión correcta solo queda preparada en tiempo de ejecución.
Auto-creación duplicada de un formulario
También se detectó una auto-creación duplicada de frmMovimientoStock en el archivo .dpr,
que fue corregida.
Son problemas menos elegantes que hablar de transacciones o índices, pero forman parte del desarrollo real: saber distinguir un problema de lógica, configuración, ciclo de vida o entorno.
22. Del CRUD al mantenimiento de software
Un CRUD demuestra que sabemos trabajar con:
INSERT
SELECT
UPDATE
DELETE
Eso es importante.
Pero una aplicación que empieza a contener información plantea problemas bastante más interesantes:
- ¿Cómo cambio el esquema sin borrar datos?
- ¿Cómo introduzco una nueva regla sin declarar incorrecto todo el histórico?
- ¿Cómo mantengo compatibilidad con versiones anteriores?
- ¿Cómo detecto inconsistencias?
- ¿Cómo impido que vuelvan a ocurrir?
- ¿Qué debe proteger Delphi y qué debe proteger SQLite?
Eso es precisamente lo que está permitiendo trabajar PC Shop.
El proyecto está sirviendo para practicar de forma conjunta:
- Delphi / Object Pascal.
- VCL.
- FireDAC.
- SQLite.
- SQL relacional.
- Mantenimiento de aplicaciones existentes.
- Migraciones de esquema.
- Compatibilidad con datos heredados.
- Integridad de datos.
- Transacciones.
- COMMIT / ROLLBACK.
- Logging.
- Diagnóstico.
- Trazabilidad.
- Auditoría.
- Restricciones CHECK.
- Índices UNIQUE parciales.
- Git.
Y aquí aparece una diferencia que considero especialmente importante desde el punto de vista profesional:
Un CRUD demuestra que puedes insertar, modificar y borrar datos.
Evolucionar una aplicación que ya contiene información, mantener compatibilidad, auditar inconsistencias y añadir protecciones sin romper lo existente se parece mucho más al mantenimiento real de software.
Conclusión
PC Shop comenzó este bloque de trabajo con algo aparentemente sencillo: mejorar el control del stock.
Pero una vez que el proyecto contiene datos reales, cada nueva funcionalidad plantea decisiones de diseño que van mucho más allá de añadir un botón o ejecutar un UPDATE.
El resultado ha sido pasar de:
PRODUCTOS.Stock = número actuala disponer de un modelo capaz de:
- registrar cómo cambia el inventario;
- relacionar esos cambios con las ventas;
- ejecutar operaciones críticas dentro de transacciones;
- detectar incoherencias;
- distinguir datos históricos de datos sometidos a nuevas reglas;
- migrar bases existentes sin perder información;
- y trasladar determinadas garantías desde Delphi hasta SQLite.
En resumen:
Registrar
    ↓
Relacionar
    ↓
Auditar
    ↓
Interpretar el histórico
    ↓
Migrar
    ↓
Prevenir
Y ese proceso probablemente sea una de las partes más interesantes del desarrollo de aplicaciones: hacer evolucionar el software sin olvidar que los datos existentes también forman parte del sistema.
Acerca del autor